项目介绍
本科毕业设计,由本人独立完成从数据采集、大数据处理、情感分析建模到可视化系统交付的完整流程。
系统采集 1497 个视频(覆盖 15 个内容分区)与 377,892 条原始评论,经 PySpark 清洗后入库 342,450 条(清洗掉约 9.4% 的短评论、超长评论与重复灌水),构建了一套端到端的视频质量评价与可视化系统。核心创新点在于:传统视频排序只依赖播放量、点赞等静态指标的固定加权,无法识别"流量大但内容一般"和"流量小但质量高"的视频;本项目引入基于评论情感分析的质量系数 Q,对各项指标进行动态加权,使排序结果更贴近真实内容质量。
技术亮点
1. 数据采集与反爬应对
使用 aiohttp + asyncio 编写异步爬虫,对接 B 站三个公开接口(分区排行榜、视频详情、评论)。通过双 Cookie 轮换、请求间隔随机化(2–4 秒)与 412 风控自动退避(暂停 5–10 分钟后继续)实现无人值守的稳定抓取,并通过 done_bvids.txt 记录已完成 BV 号实现断点续传。
2. 大数据处理流水线
在 WSL2 Ubuntu 22.04 中从零搭建 Hadoop 3.3.6 伪分布式集群与 Spark 3.5,使用 PySpark 设计完整清洗流水线:嵌套字段扁平化、时间戳转换、UDF + 正则去除 B 站表情标签(如 [doge])、URL、@用户名与"回复@xxx:"前缀,并通过窗口函数剔除同一用户在同一视频下的重复灌水评论。
中间结果以 Parquet + Snappy 列式存储,相比原始 JSON 节省约 70% 存储空间,Spark 读取速度提升约 5 倍。
3. 评论情感分析
集成 Erlangshen-RoBERTa-110M-Sentiment 中文情感模型,基于 PyTorch + CUDA 在 RTX 3070 Ti 上完成全量推理。设计分块批处理策略(每块 5000 条、批大小 64)与 .done_chunks.txt 断点续传机制,在 12 万条评论的基线运行中推理耗时约 14 分钟,平均约 200 条/秒。
通过对照实验验证模型选型:相比初期使用的京东评论微调模型,替换为 Erlangshen 后负向评论识别占比由 26.5% 提升至 38.5%,情感分数标准差由 0.629 提升至 0.783,模型区分度提升约 24%,更贴合 B 站"夸赞与吐槽并存"的真实评论生态。
4. 动态权重综合评分模型(核心创新)
构建评论质量系数 Q,由三个互补维度组成:
Q = 0.5 · sigmoid(2S) + 0.25 · C + 0.25 · D
- S:点赞加权后的情感倾向,衡量群众共识
- C:评论一致性(基于情感分数标准差),区分普遍认可与两极分化
- D:讨论深度(基于模型置信度比例),过滤水评论
在评分公式中对高 Q 视频降低播放量权重、提高投币与收藏权重(W_view = 0.30 · (1 − 0.3 · Q)),并引入 0.20 · Q 作为独立质量维度;所有指标经 log + min-max 归一化以处理长尾分布。
在 758 个视频上的实验结果显示:排名上升幅度最大的 Top 10 均为音乐歌单、深度赏析与生活向慢内容(Q 均值 0.71),排名下降最大的 Top 10 均为标题党与擦边动画类内容(Q 均值 0.46),与人工直觉判断一致。
5. 后端与数据存储
设计 MySQL 三表结构(videos / video_scores / comments),通过 bvid 建立外键关联并对高频查询字段建索引;将 bvid 列 collation 调整为 utf8mb4_bin 以严格区分 BV 号大小写。使用 pymysql 批量 INSERT IGNORE 灌库,30 万行约 18 秒完成。
Flask 后端提供 8 个 RESTful 接口(健康检查、分类列表、排行榜、视频详情、情感分布、评论列表、评分对比、全局统计),使用 DBUtils 连接池管理连接、全部 SQL 参数化防注入,接口平均响应时间在 50 ms 以内。
6. 可视化前端与在线按需分析
基于 Vue 3 + Vite + Element Plus + ECharts 5 实现三个核心页面:首页排行榜(静态/动态评分模式切换、质量系数 Q 分级进度条、排名变化箭头)、视频详情页(Q 三维雷达图、评论情感饼图、四种排序与情感筛选)与模型对比页(排名升降 Top 15 对比、全样本 Q-排名变化散点图、各分区平均 Q 分布)。
此外实现了在线按需分析:用户输入任意 BV 号或视频链接,后端自动完成抓取、清洗、模型推理、Q 值计算、评分与入库全流程,30–60 秒内返回完整分析结果,将系统从"静态展示"升级为"按需服务"。
交付物
- 毕业论文《基于大数据的哔哩哔哩视频数据分析和综合评分可视化系统》
- Bilibili 系统演示视频
系统界面
以下截图取自系统实际运行状态。注意总览中的「视频总数」为动态值:离线采集 1497 个, 其余由在线按需分析在运行期动态追加(最终入库 1505 个),因此截图中的数字会大于 1497。
1. 排行榜首页
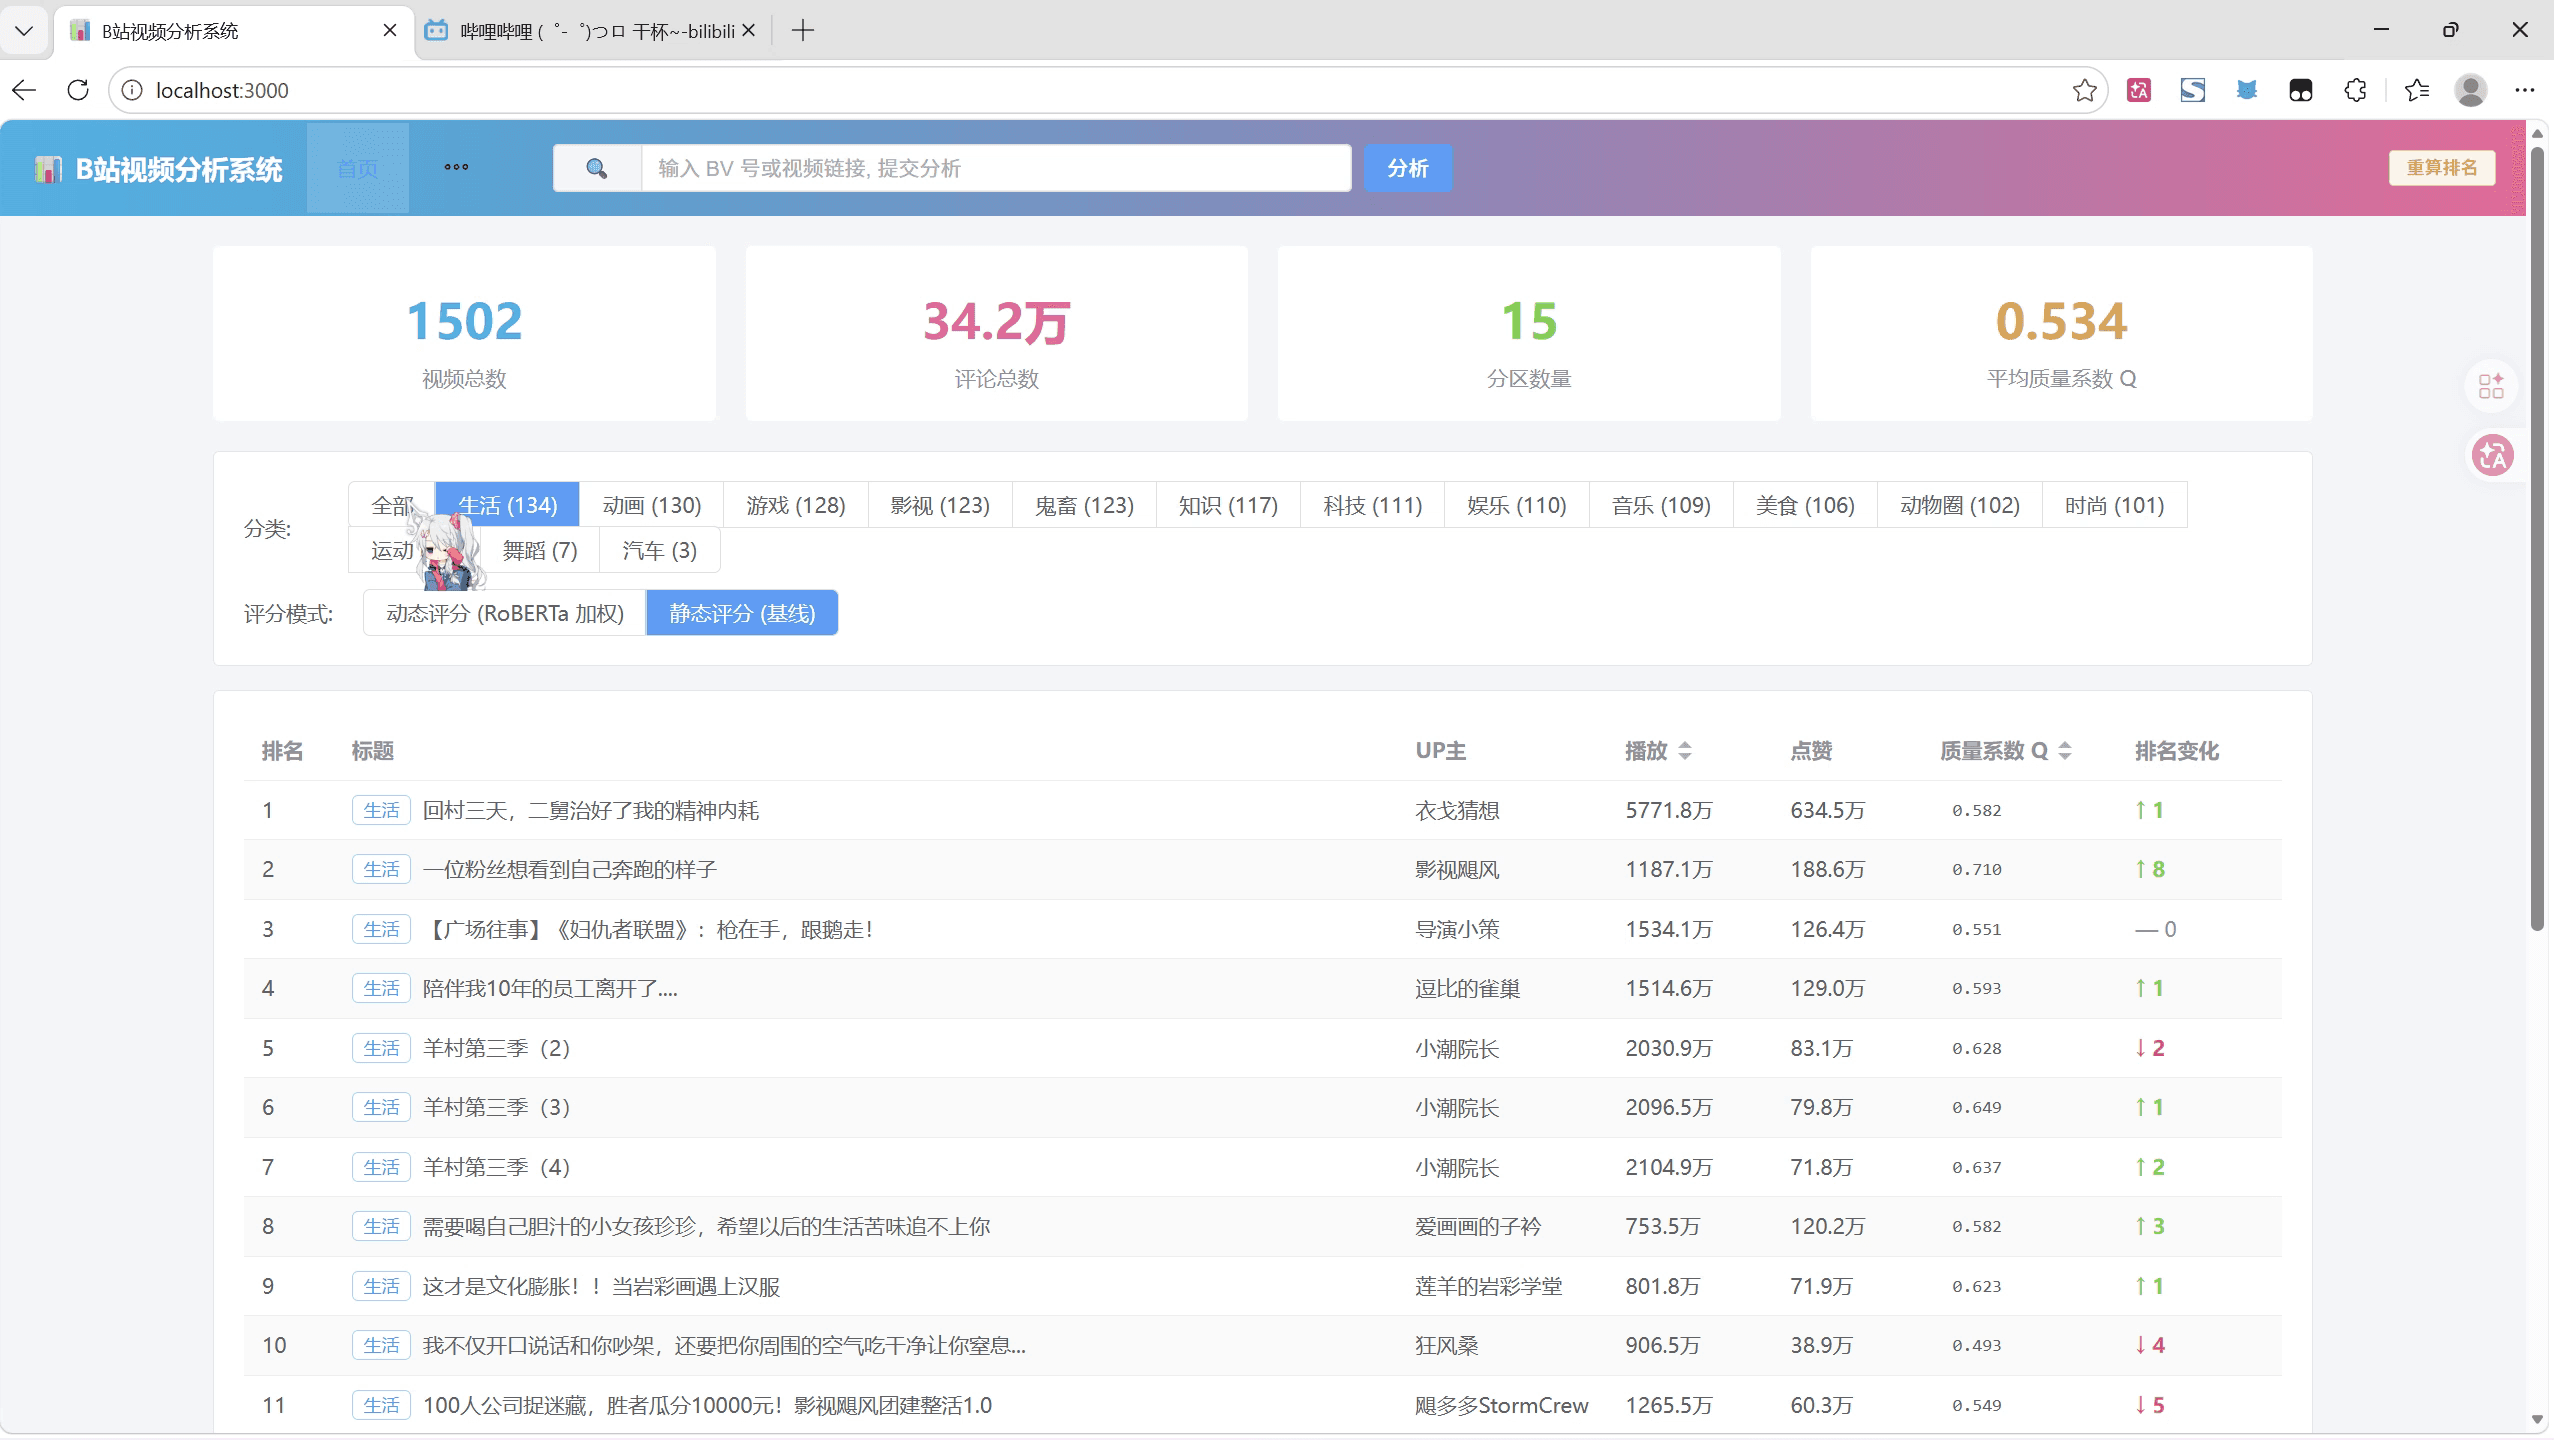
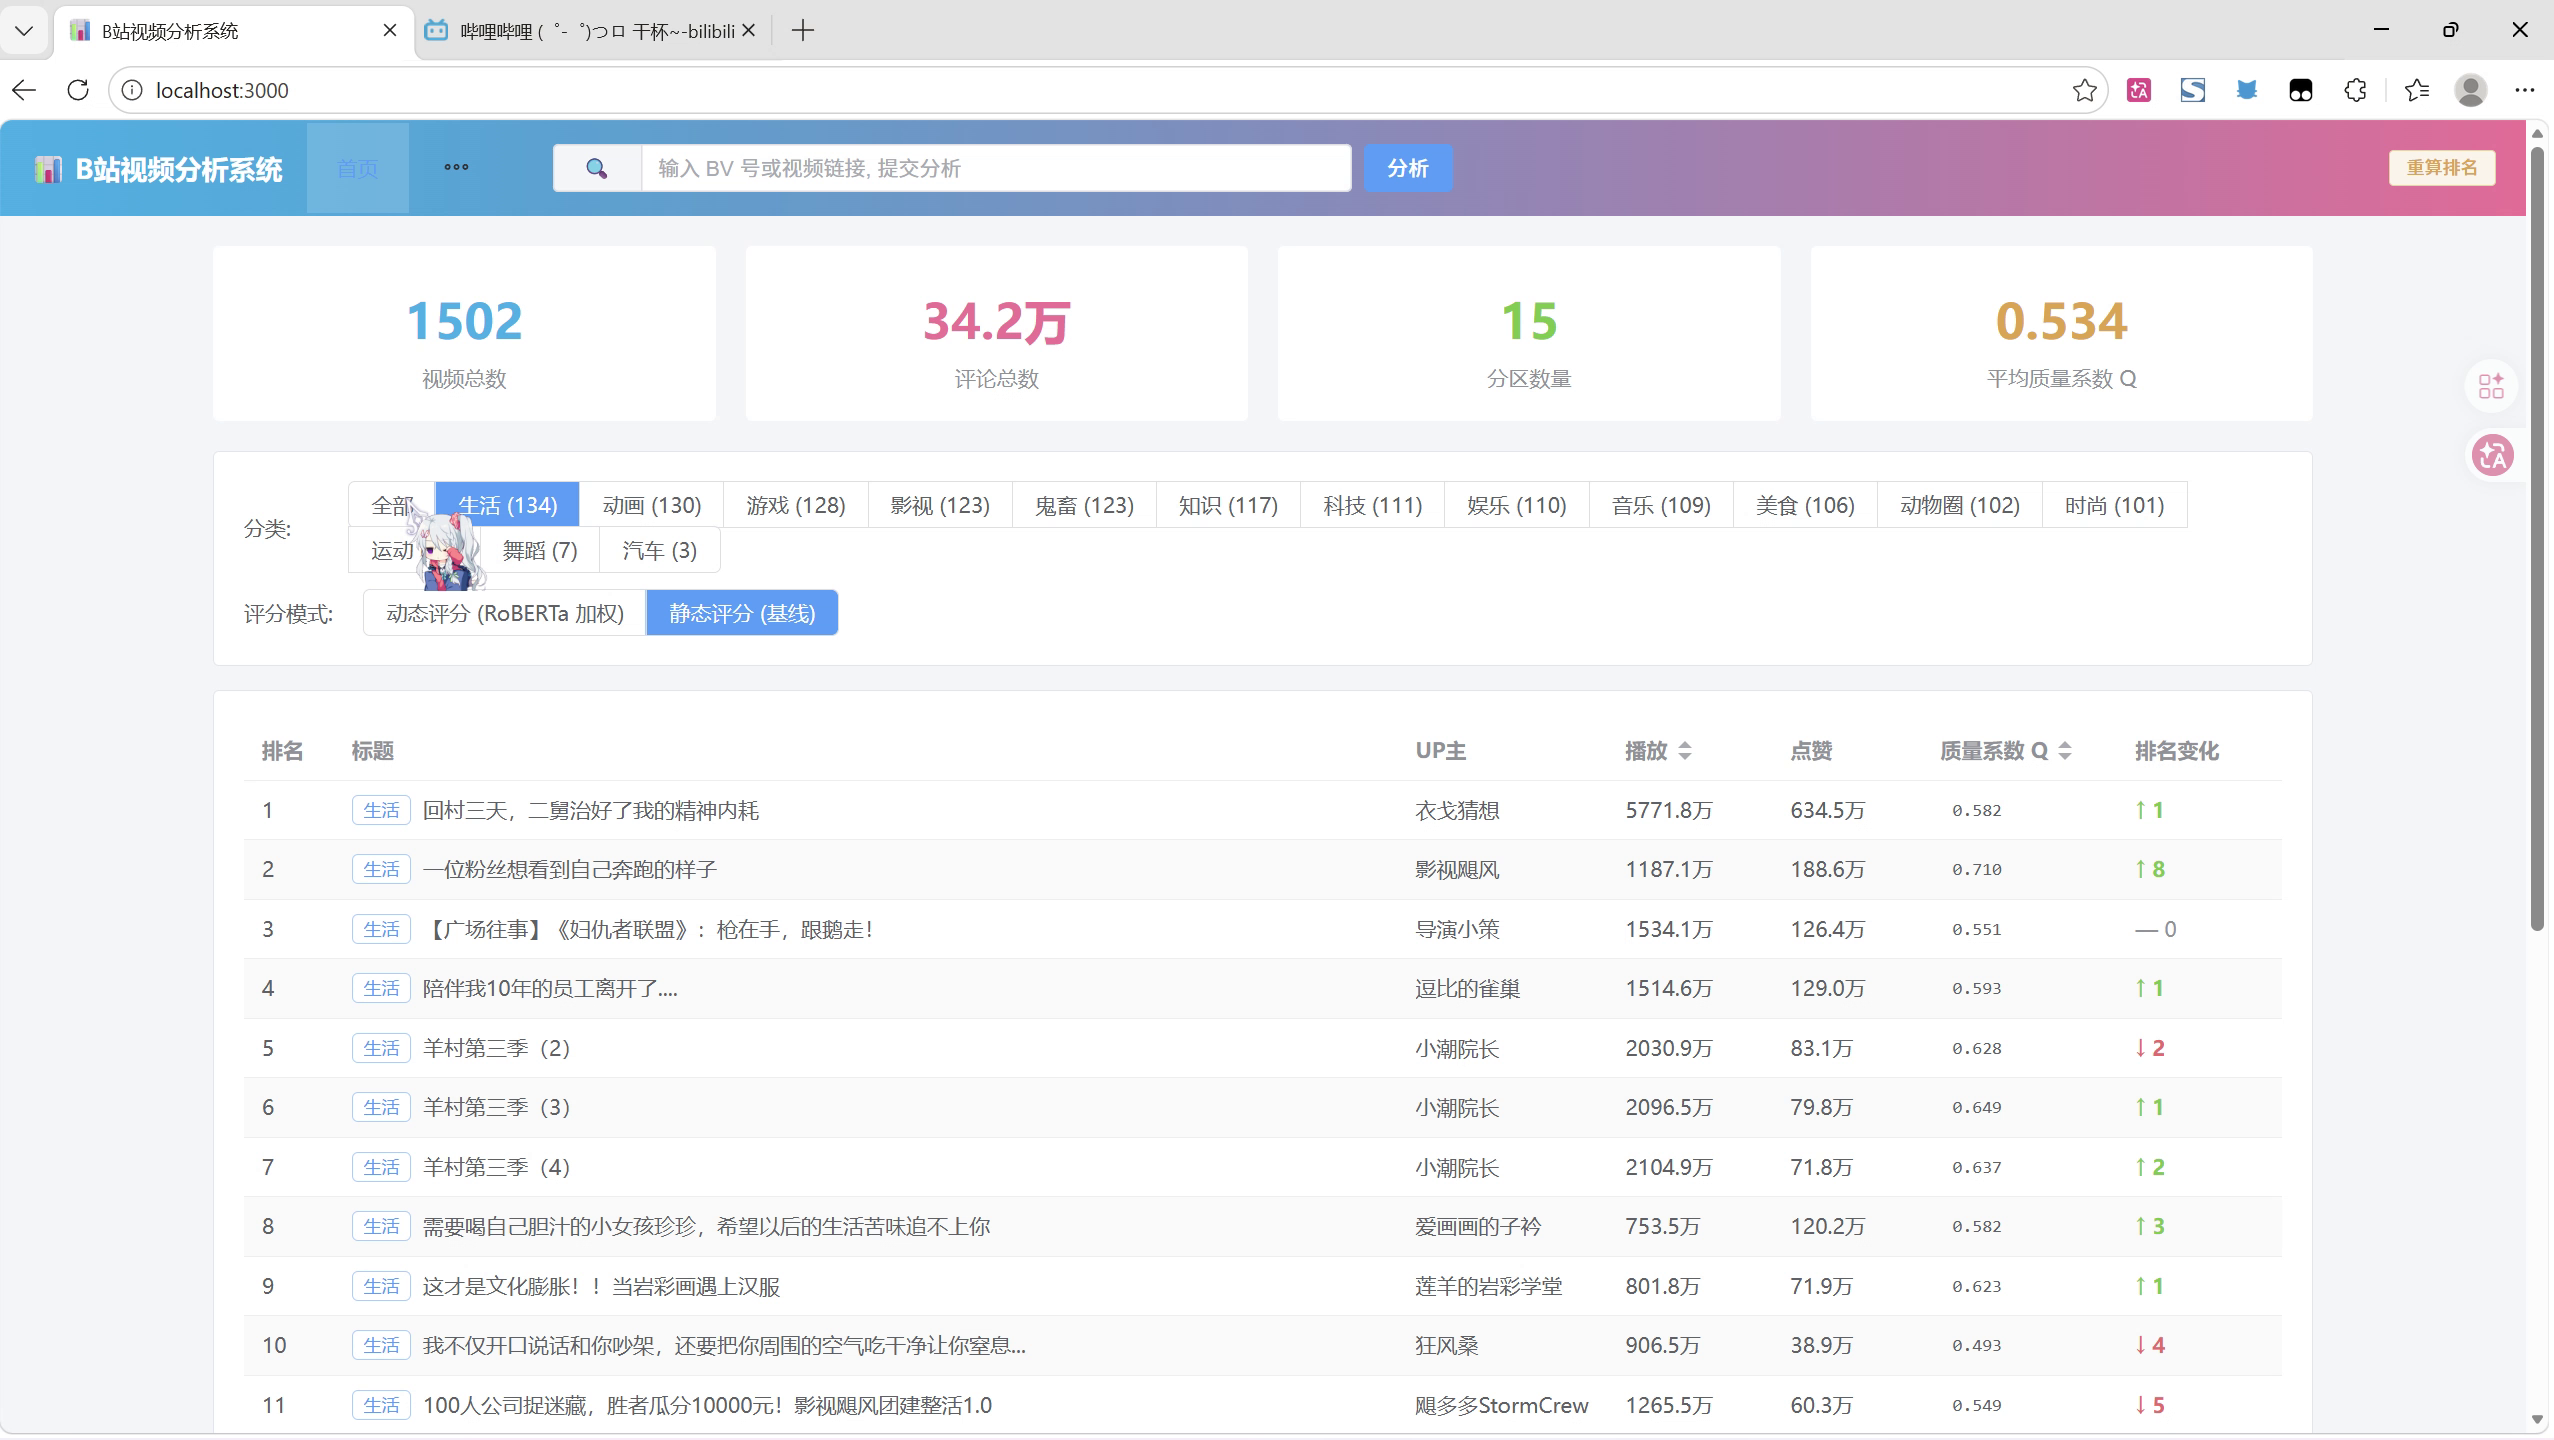
顶部为系统总览(视频总数 / 评论总数 / 分区数量 / 平均质量系数 Q),下方排行榜直接给出每个视频的质量系数 Q与排名变化,并支持按 15 个分区筛选。
2. 动态权重 vs 静态权重
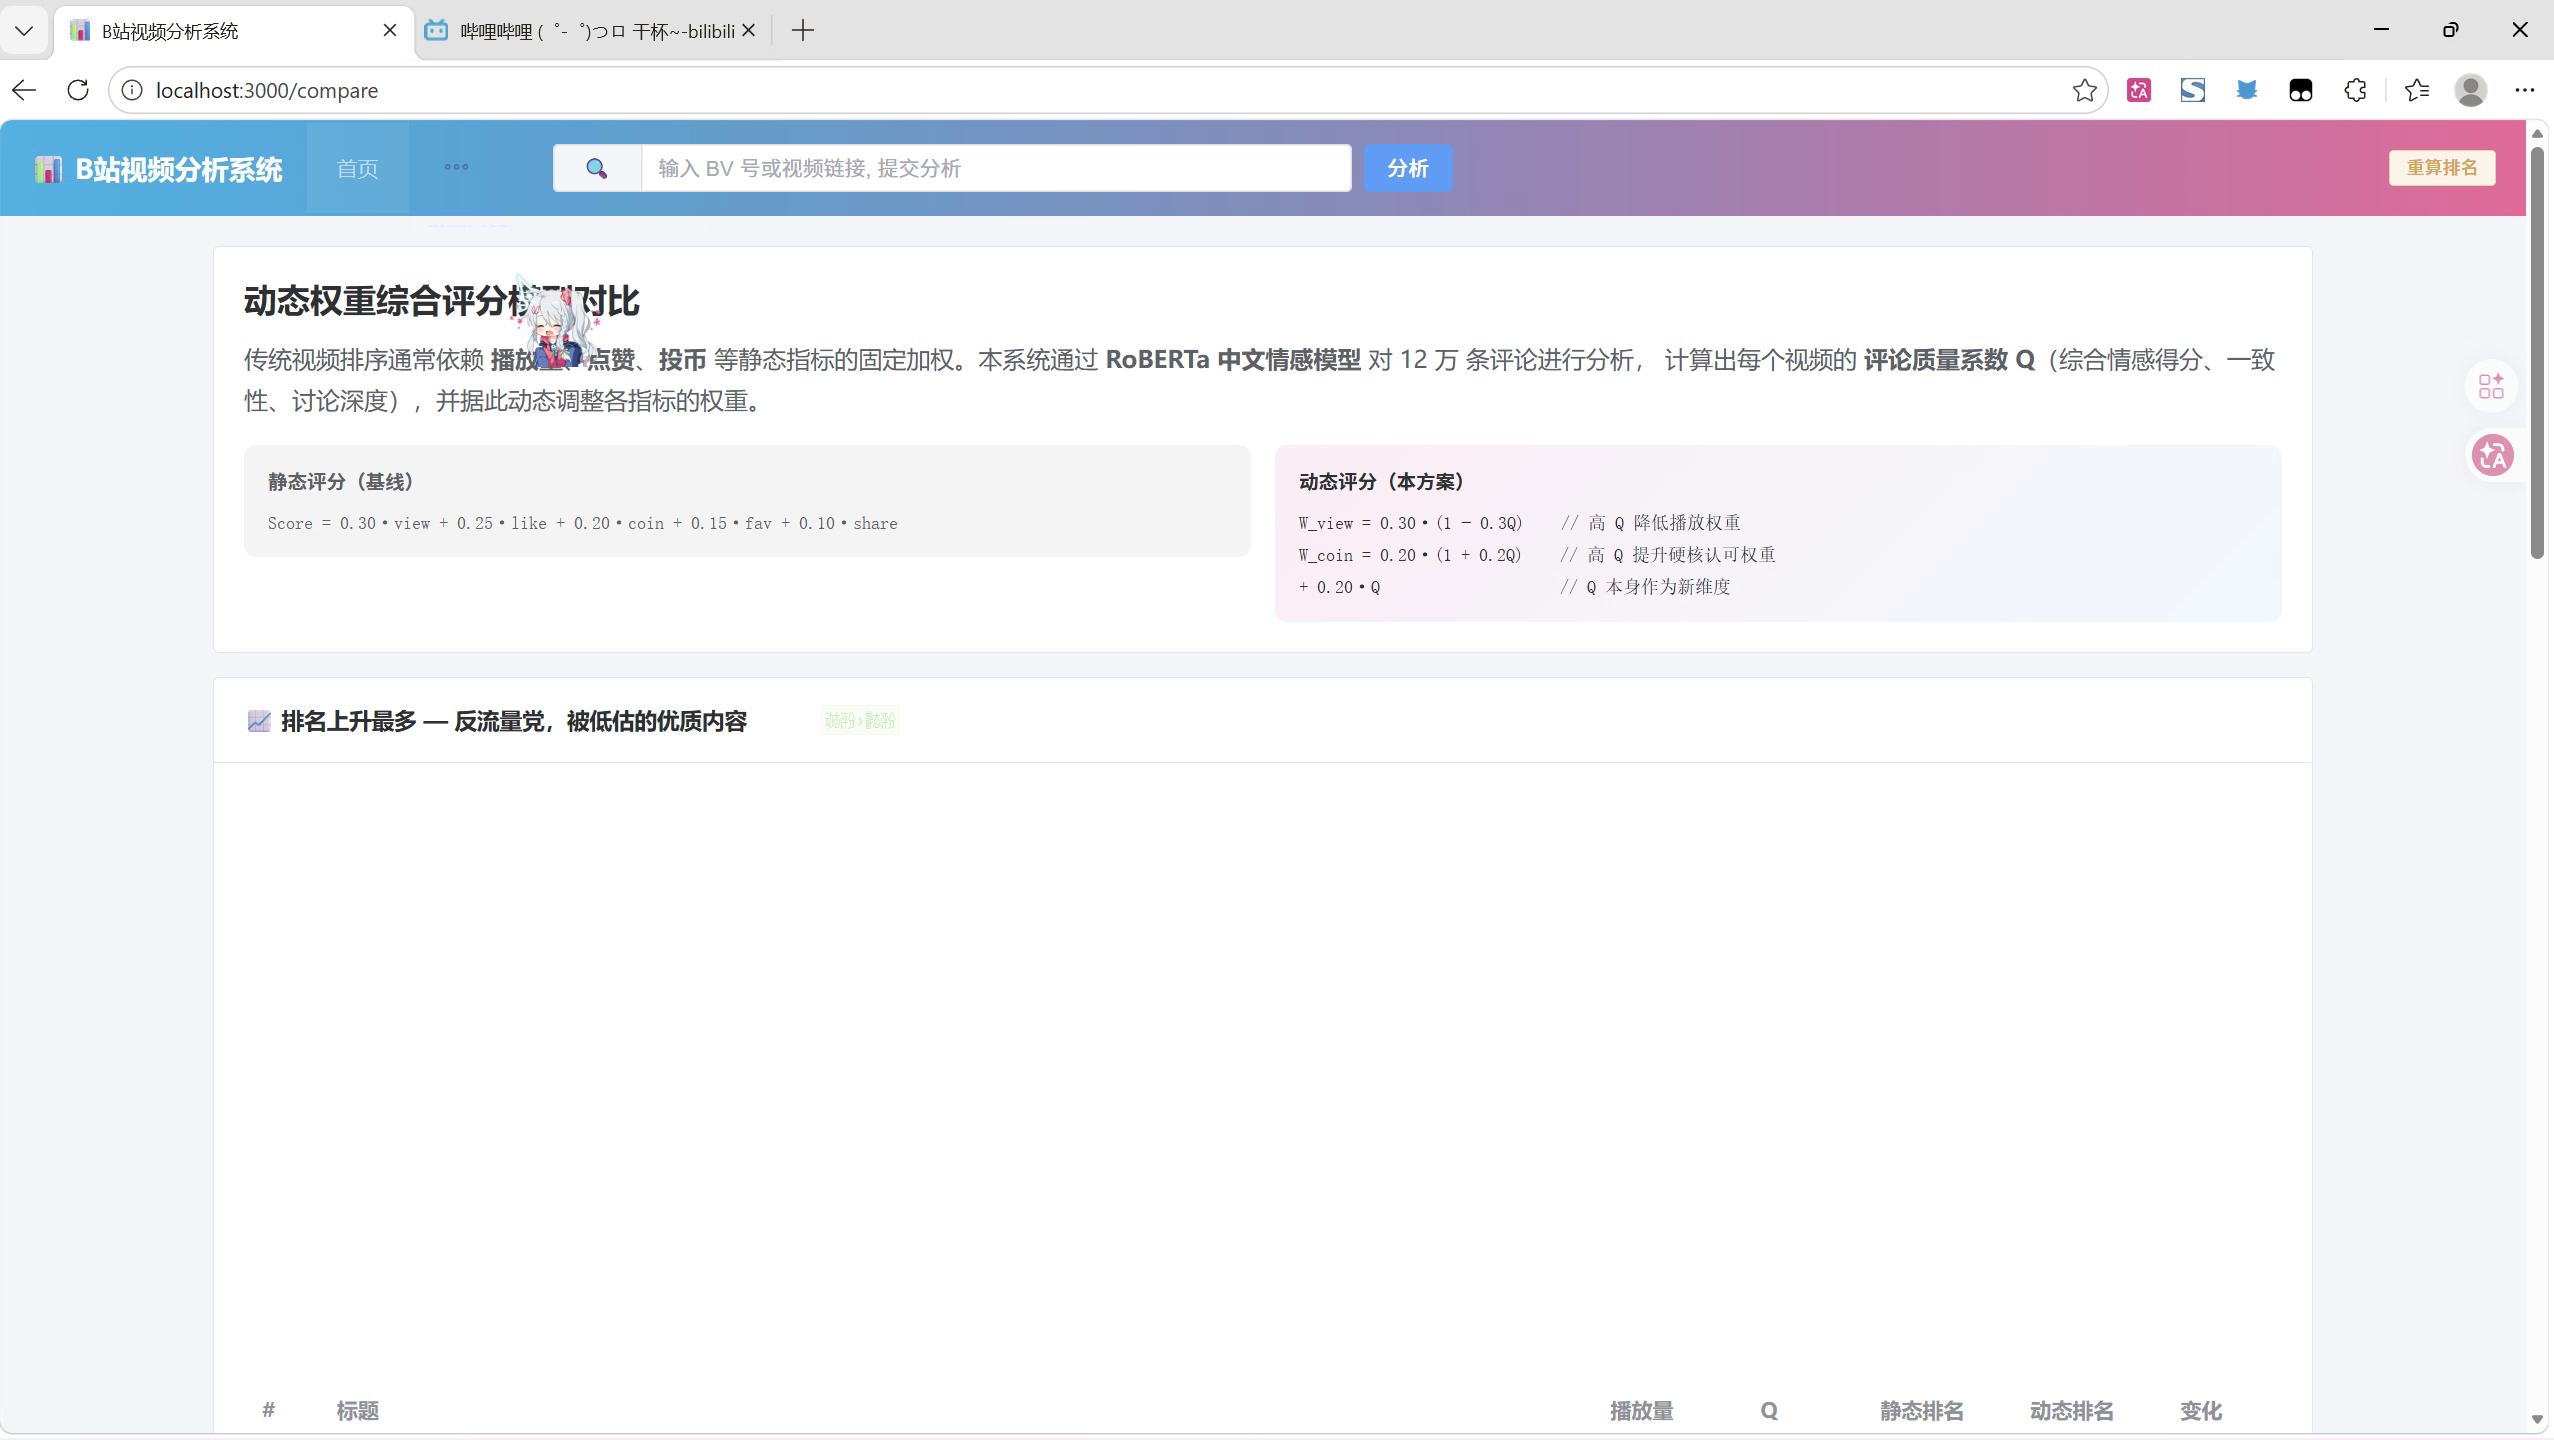
传统静态公式为固定权重(播放 / 点赞 / 投币等)。本项目在各项指标上引入评论质量系数 Q 进行动态加权——对高 Q 视频降低播放量权重、提高投币与收藏权重。
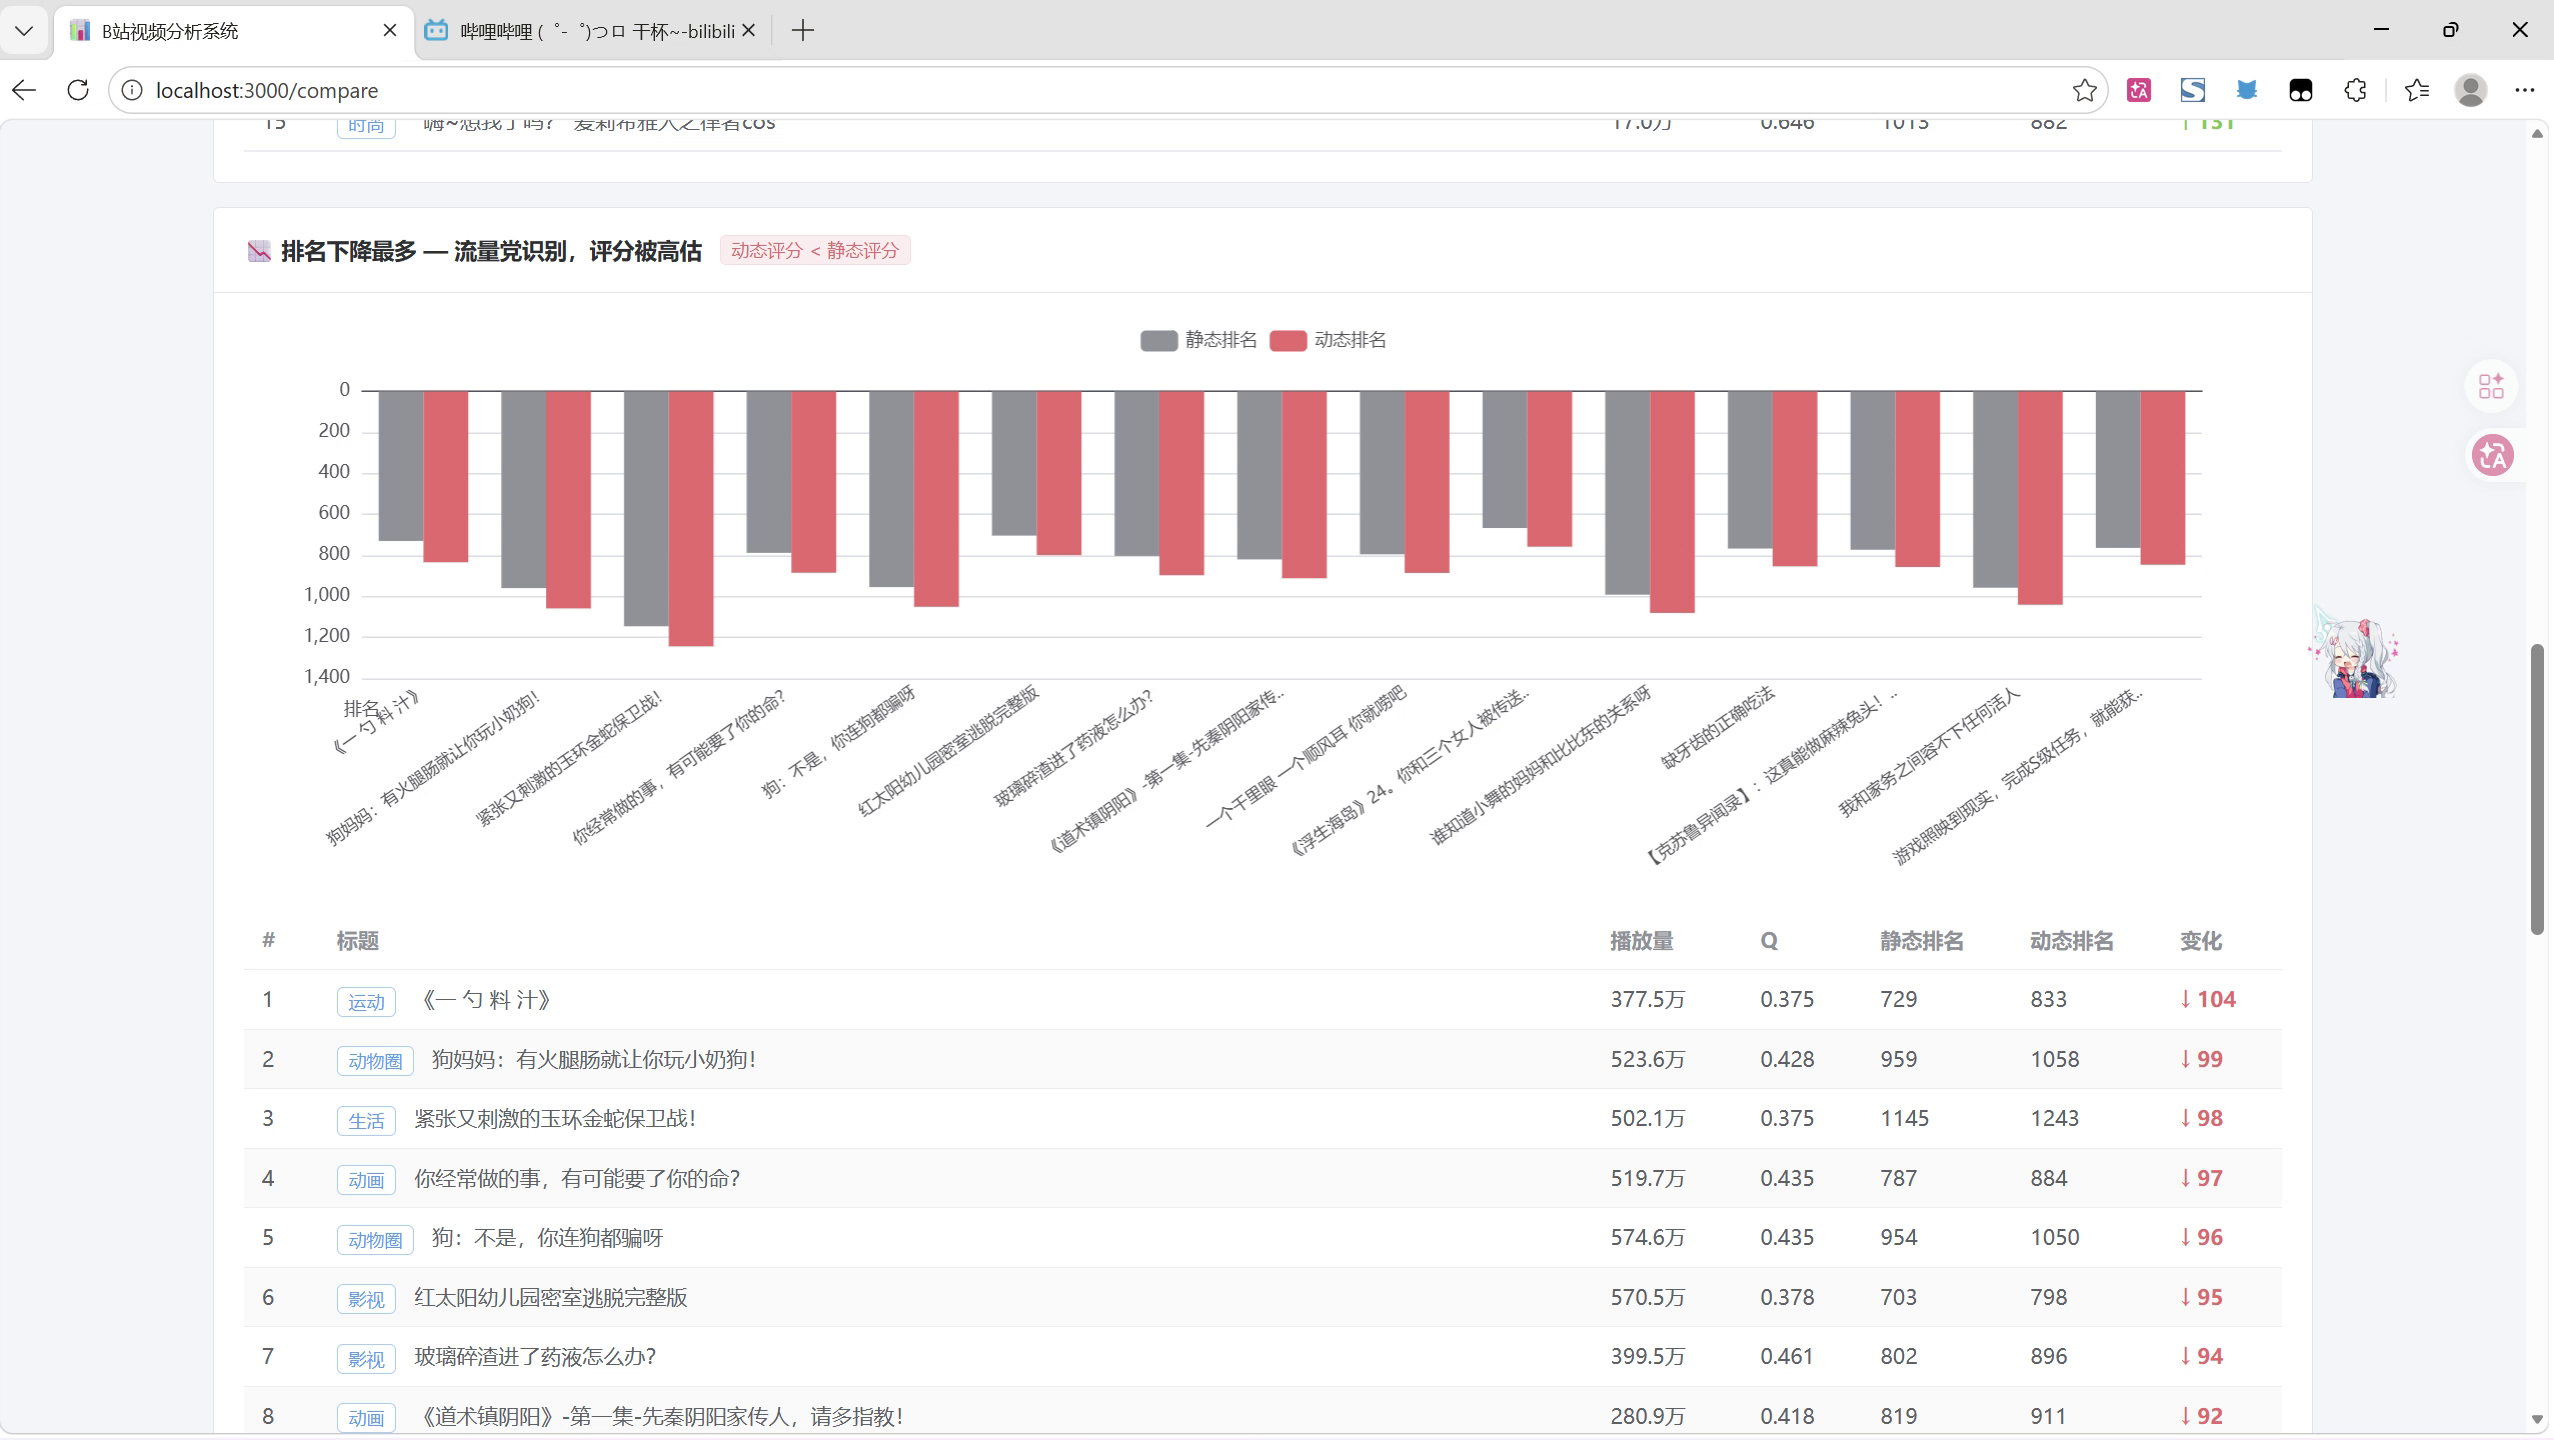
3. 排名变化分析
动态权重下排名下降最多的视频(标题党与擦边动画类内容,Q 均值 0.46),与排名上升最多的一批(音乐歌单、深度赏析类,Q 均值 0.71)形成对照。
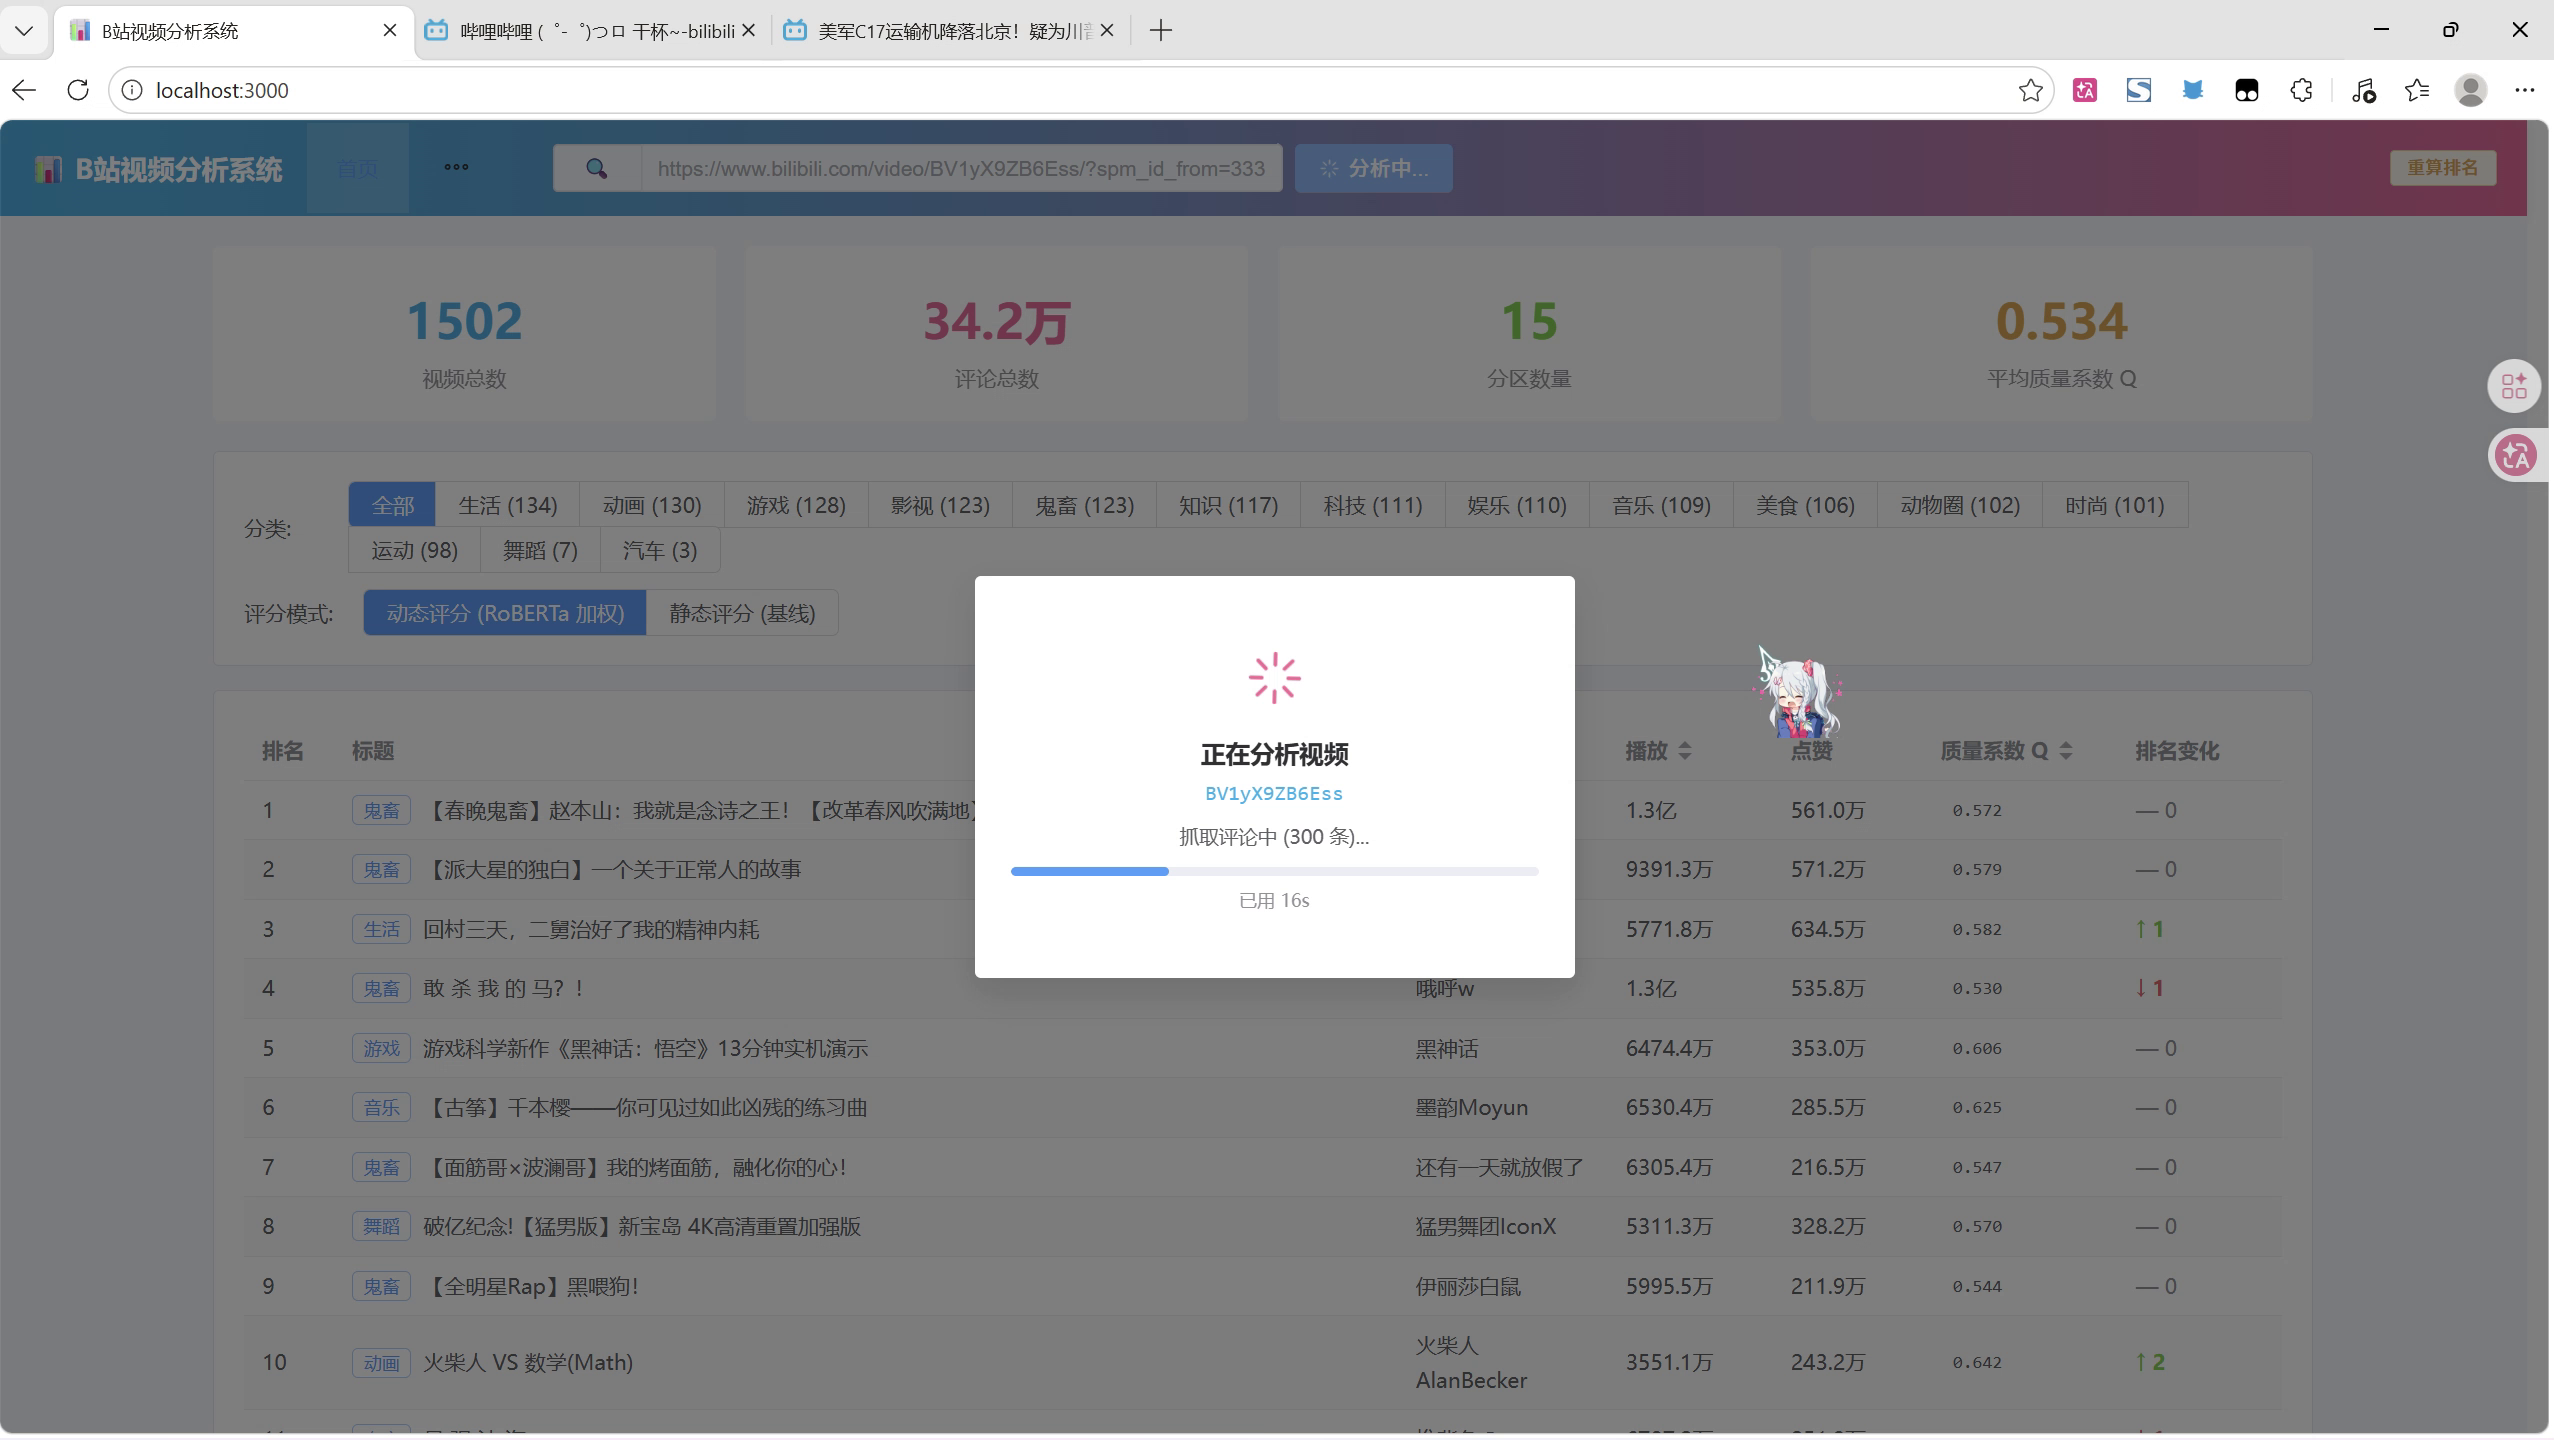
4. 在线按需分析
输入任意 BV 号或视频链接,后端自动完成抓取 → 清洗 → 情感推理 → Q 值计算 → 评分 → 入库全流程,全过程实时回传进度(图中为分析进行中)。
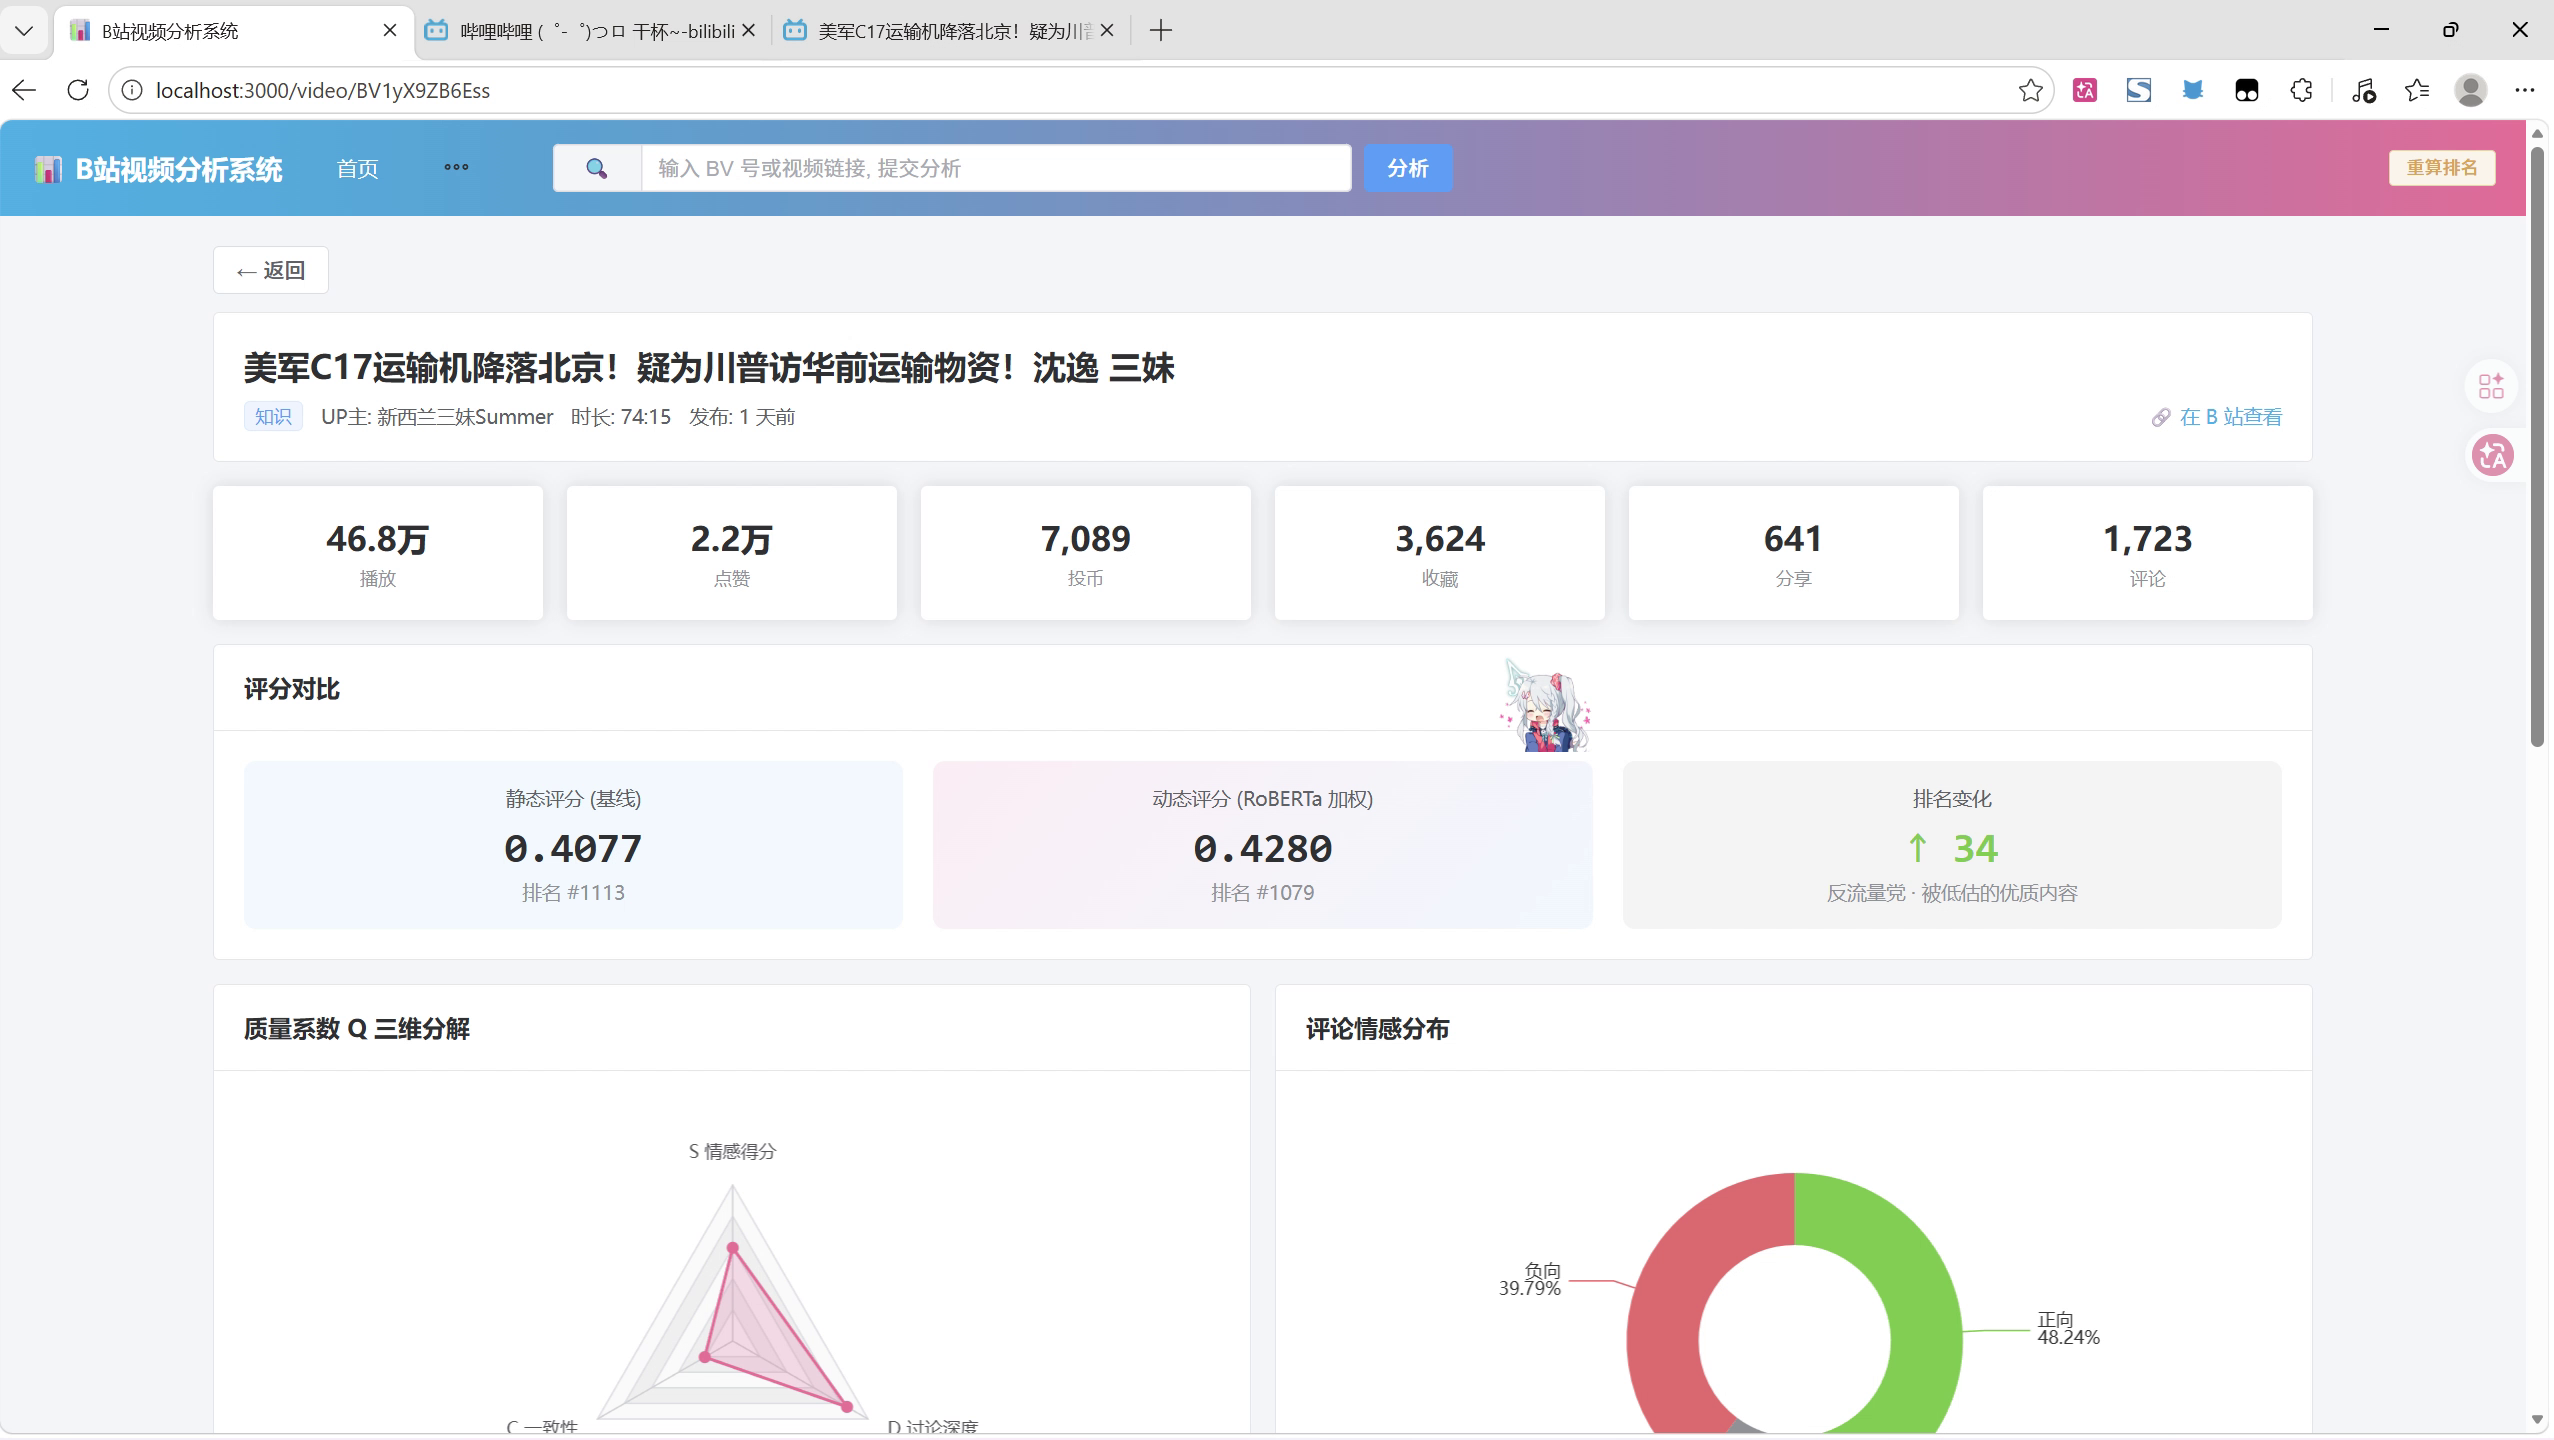
5. 视频详情页:质量系数 Q 三维分解
单个视频的静态 / 动态评分对照与排名变化,以及质量系数 Q 的三维雷达图(S 情感倾向 / C 一致性 / D 讨论深度)与评论情感分布。
6. 评论级情感分析结果
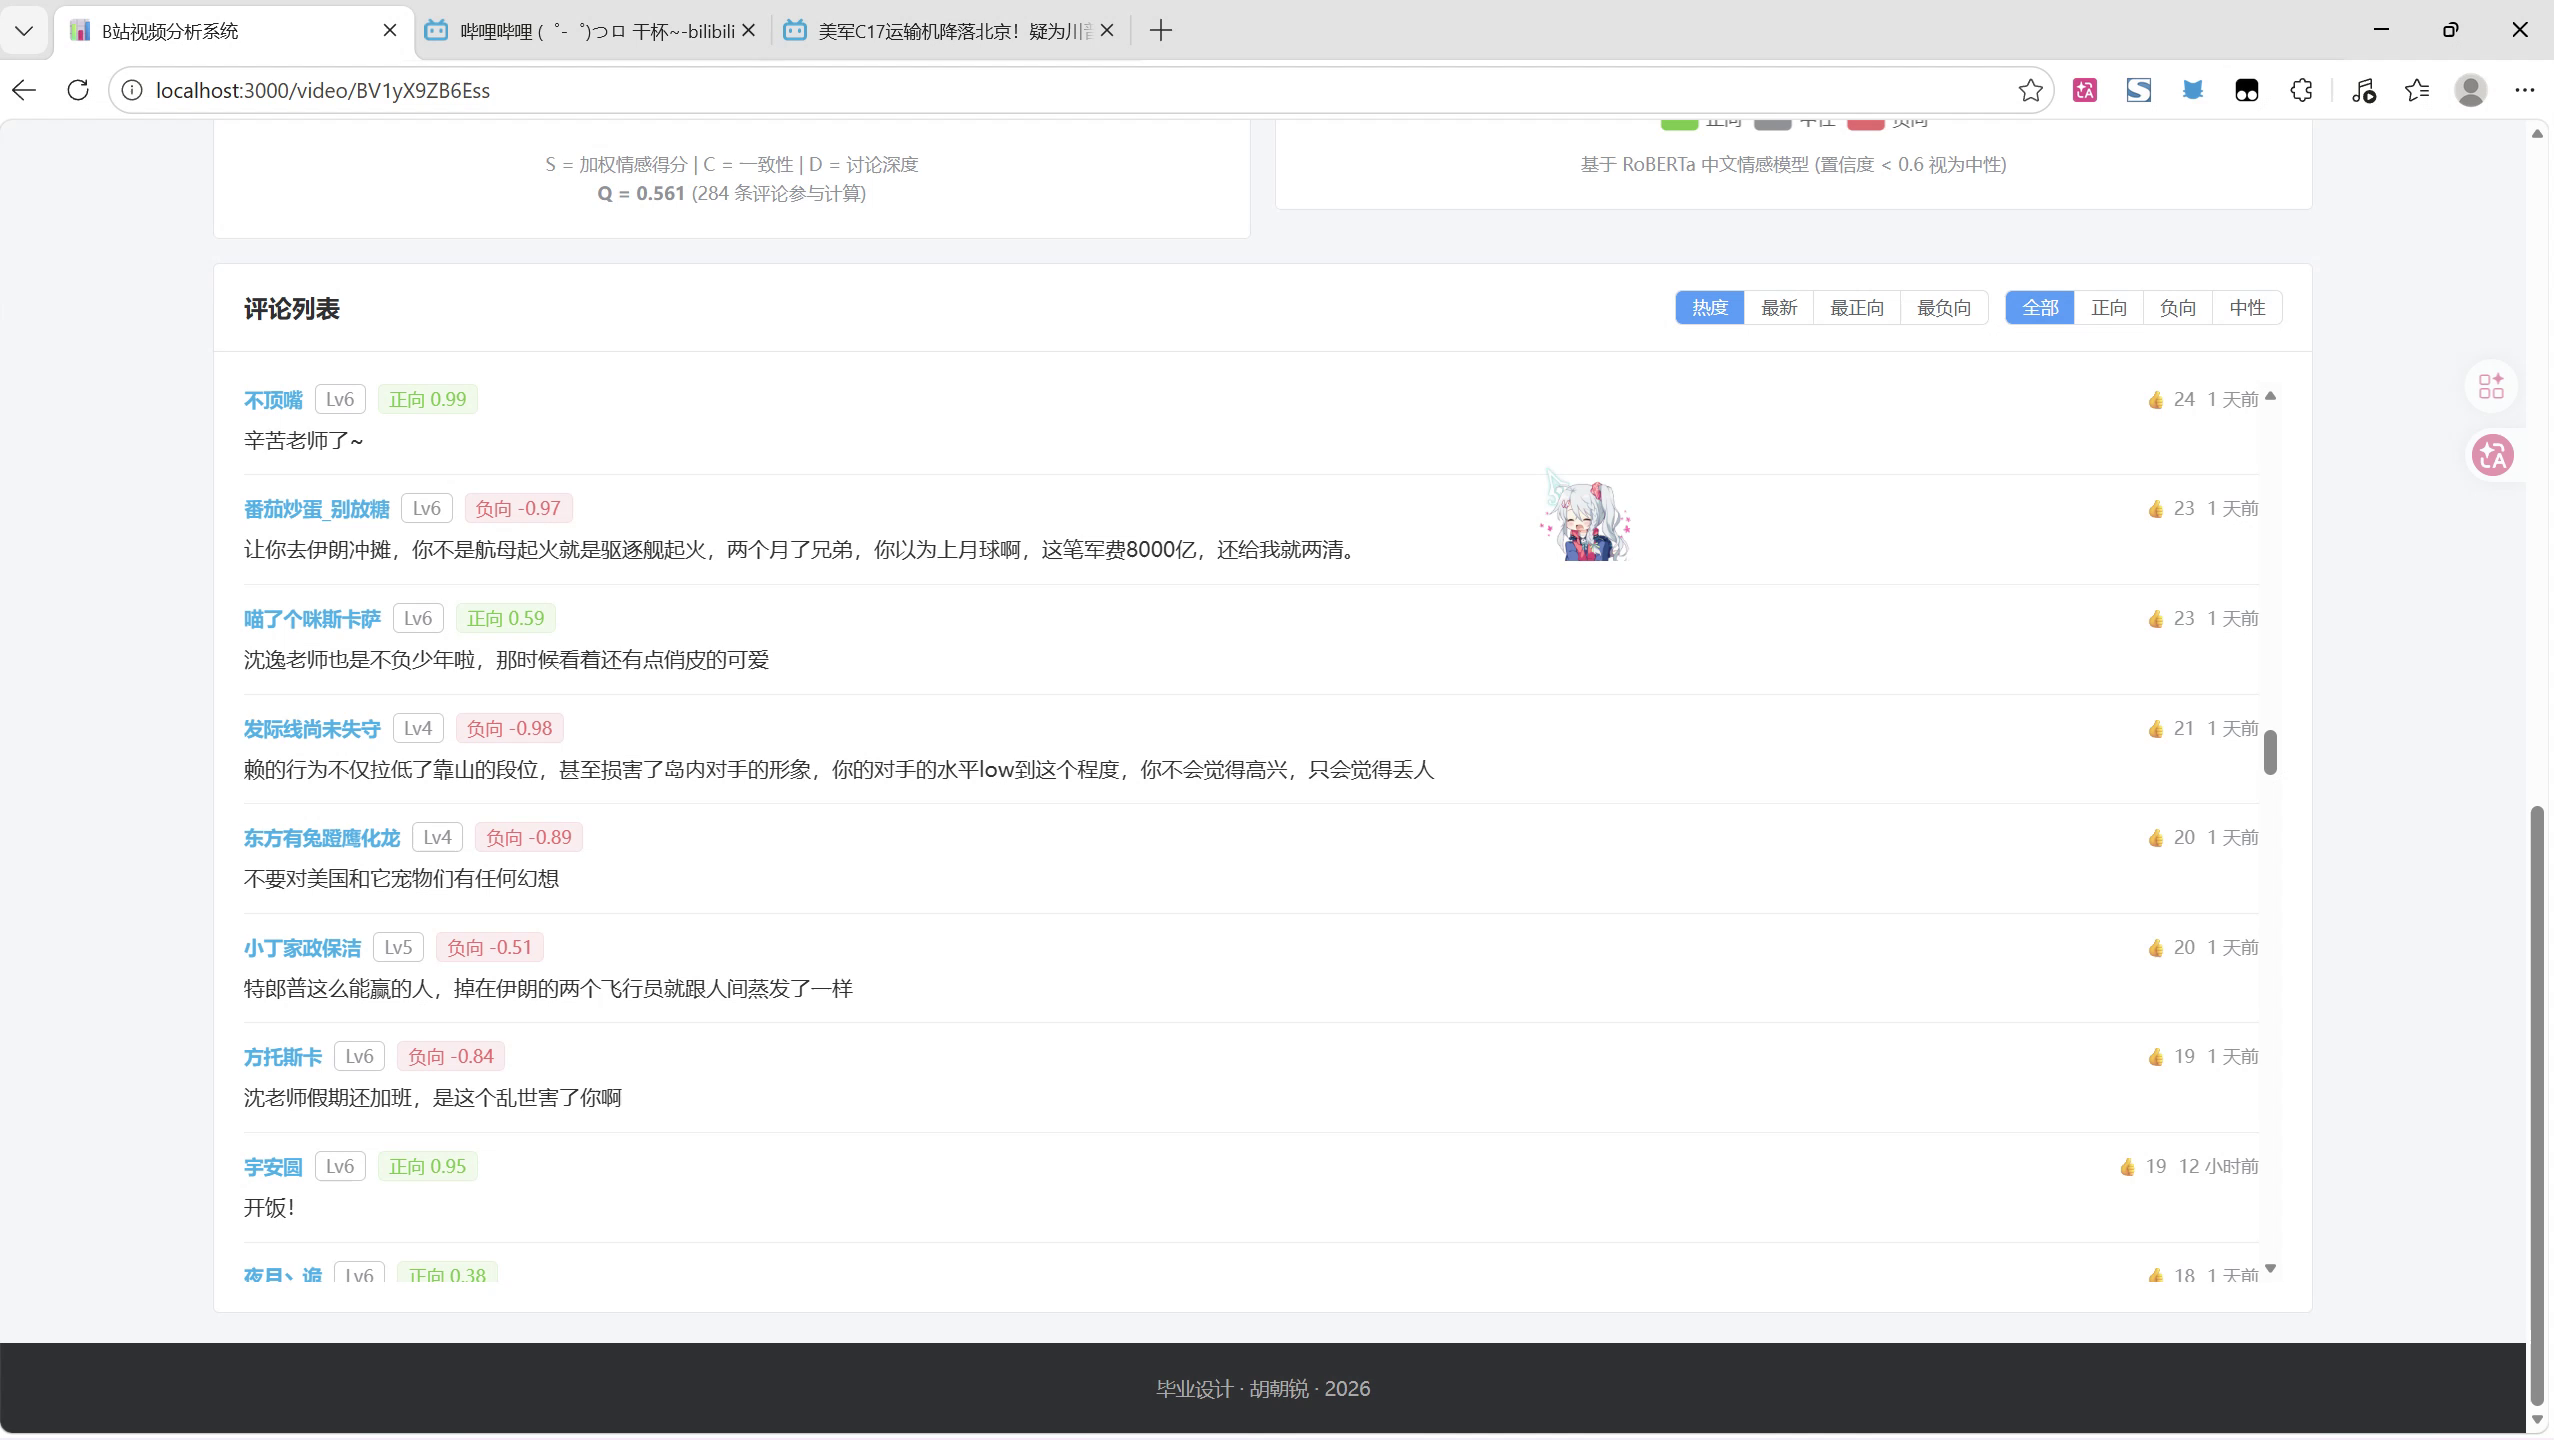
每条评论输出情感标签、sentiment_score 与 confidence,支持按热度 / 最新 / 最正向 / 最负向排序。